
- By - Astrid
- Posted on
- Posted in Veranstaltungen
Zum Einstieg Workshops
Zum Einstieg Workshops
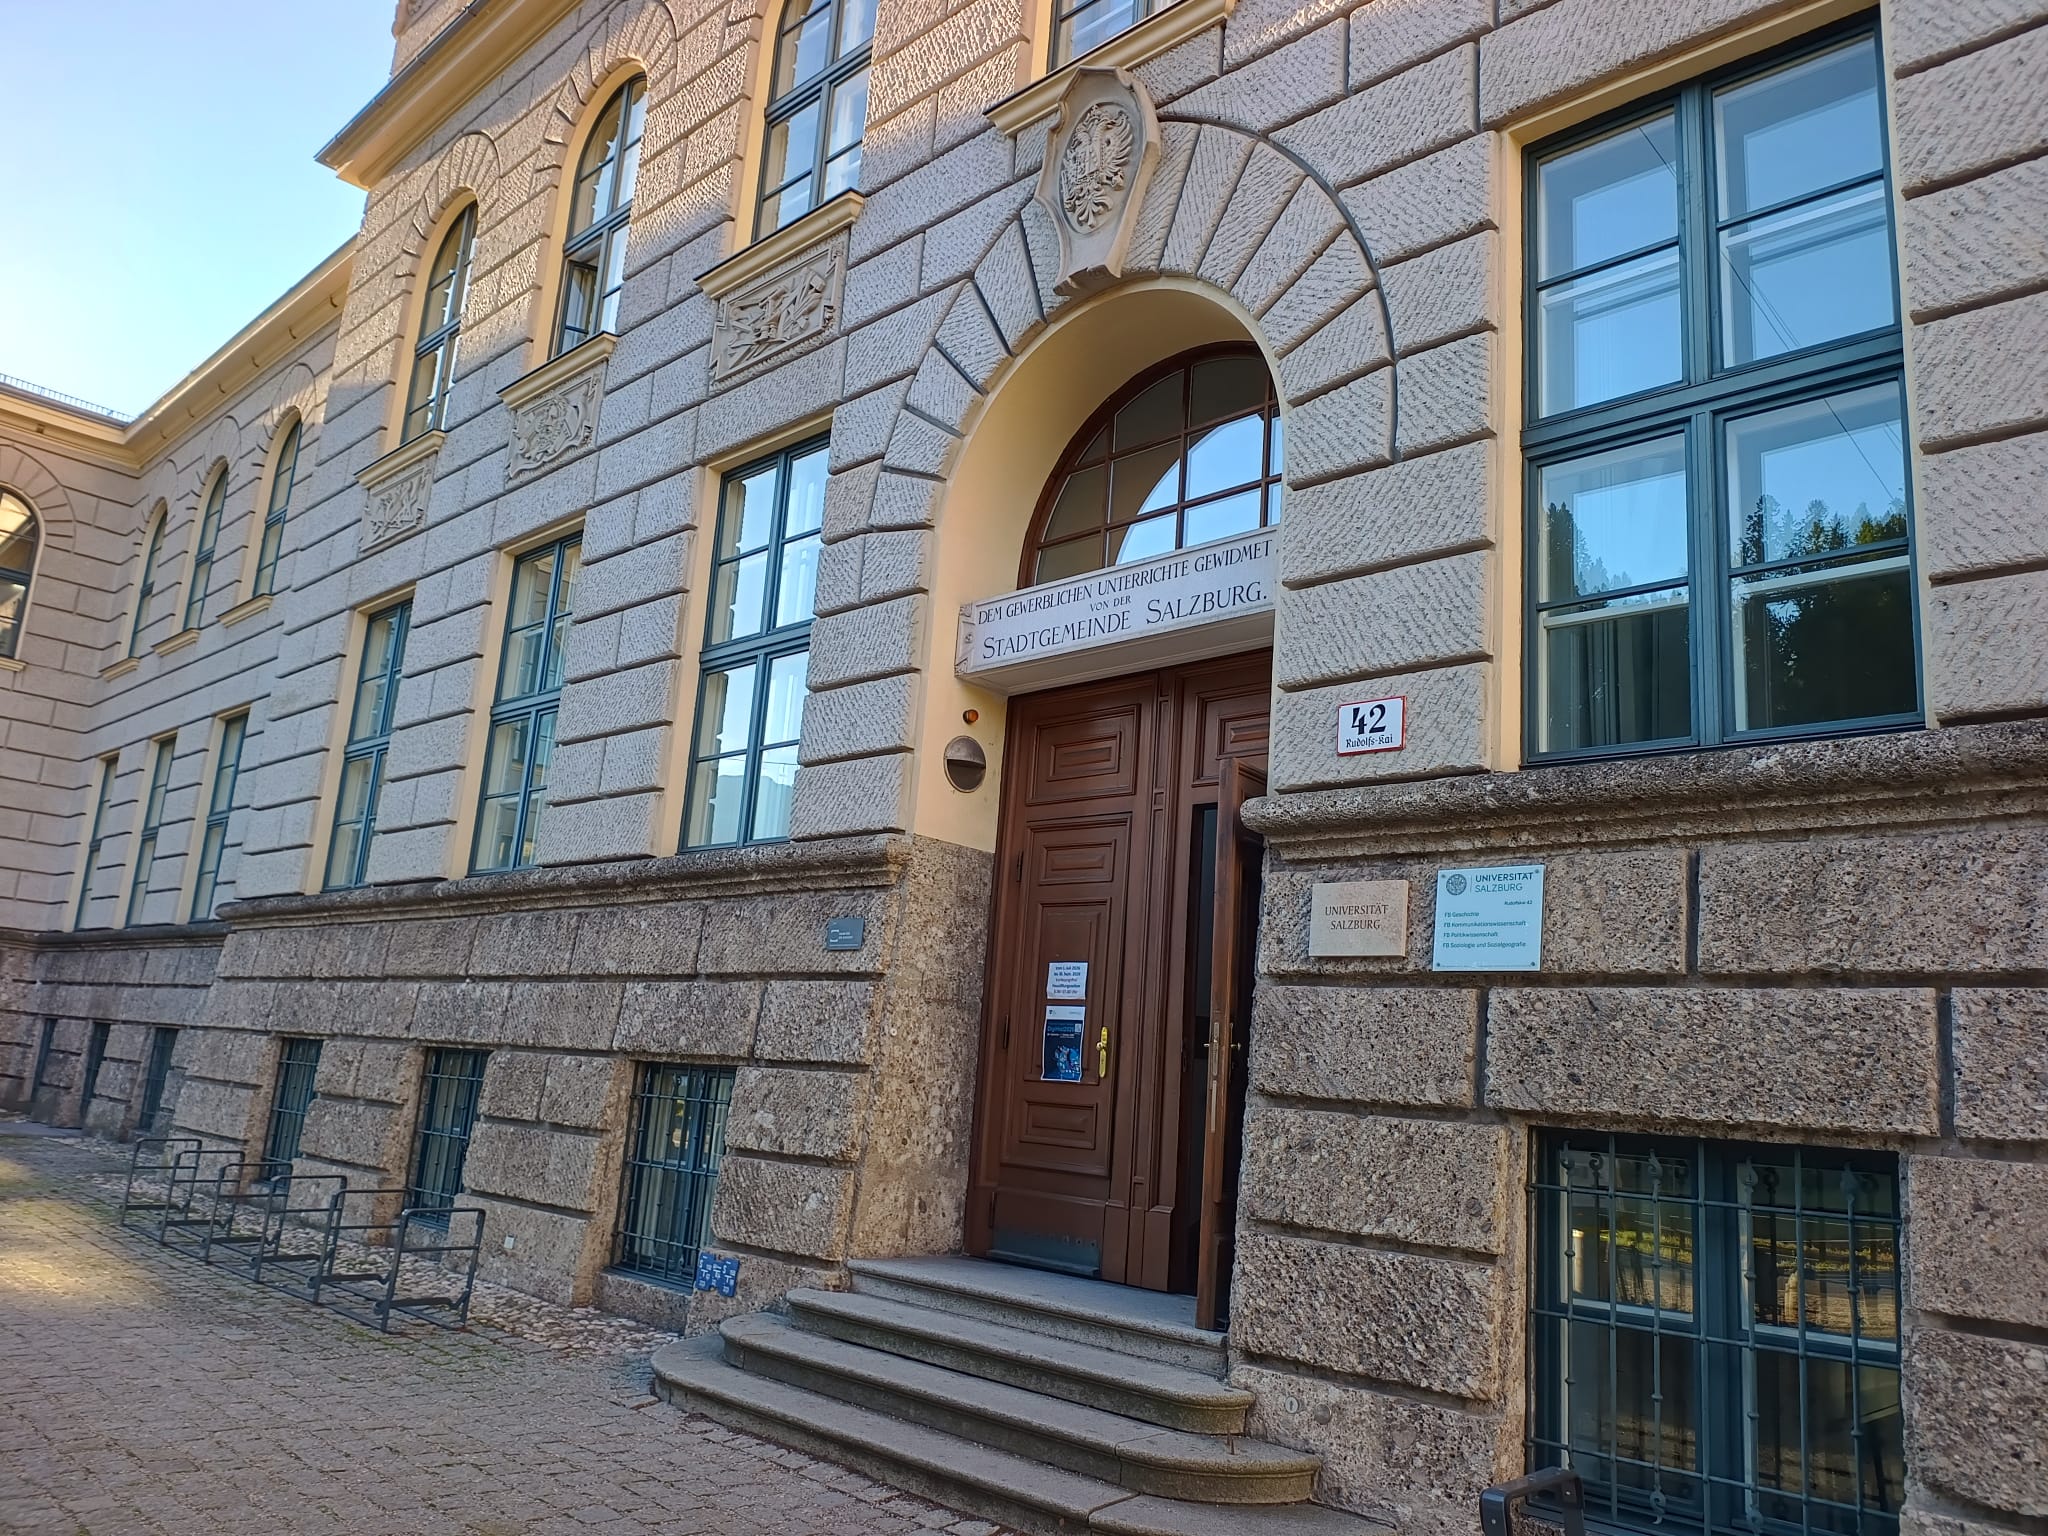
Der Montag begann etwas verwirrend, die Workshops fanden bereits vor dem eigentlichen Beginn der Konferenz statt, aber wir wurden trotzdem herzlich an der Universität aufgenommen und starteten dann ohne große Eröffnunsgreden, die fanden dann erst am Dienstag statt.
So sind wir dann direkt in den Workshop „Erschließung und Verantwortung: Ethische Herausforderungen bei der digitalen Erfassung des kulturellen Erbes“ gestartet und nach der üblichen Vorstellungsrunde haben wir einen kurzen Überblick zum Thema Ethik und vor allem Ethik in Museen und Ausstellungen erhalten. Letztlich zeigte sich, wie umfassend dieses Thema ist und in wie viele Bereiche es hineinreicht.
Die Probleme beginnen bereits beim Erwerb von Sammlungsobjekten. Nicht nur die Legalität von Erwerbungen aber auch deren moralische Vertretbarkeit stellen im Nachgang Herausforderungen das. Während NS-Raubkunst noch recht eindeutig ist, zumindest wenn sie denn als solche identifiziert werden kann, wird es bei Erwerbungen aus kolonialen Kontexten oft schnell schwierig. Selbst bei genehmigten Grabungen und Käufen bleibt die Problematik der starken Machtgefälle zwischen den beteiligten Parteien. So lässt sich kaum nachvollziehen, wie freiwillig diese Grabungs- und Exportgenehmigungen tatsächlich erteilt wurden. Auch über menschliche Überreste wird bis heute diskutiert und mittlerweile wurde viele an die jeweiligen Herkunftsethnien zurückgegeben, so dass diese entsprechend dem eigenen Glauben beerdigt werden konnten. Gleichzeitig wird auch immer mehr über Werke von Personen diskutiert, denen Verbrechen entweder vorgeworfen oder auch nachgewiesen wurden und es gibt bis heute keinen Konsens zur Trennung von Künstler und Werk. Und auch Werke die in Diktaturen entstanden sind werden heute kritisch gesehen.
Beim Ansprechen der zahlreichen Problematiken konnten wir uns immer wieder austauschen aber am Ende blieb trotzdem das Gefühl, das es nicht die eine Lösung gibt. Am Ende muss jedes Museum, jede Ausstellung und jede Einrichtung selbst entscheiden, wie es mit den ganz eigenen Problemfällen umgeht. Und manchmal muss man auch den Mut haben zu scheitern, etwas versuchen und dann festzustellen: „So funktioniert es nicht.“ ist immer noch besser als gar nichts zu machen und aus Fehlschlägen lernt man oft mehr als aus Erfolgen.
Der zweite Workshop „User-guided image processing and automated text recognition of digitised historical documents“ war dann weniger Austausch und mehr praktische Anleitung. Zwei unterschiedliche Tools wurden vorgestellt und wir erhielten die Möglichkeit entweder mit Demodaten aber auch mit eigenen Daten diese auszuprobieren und Fragen zu stellen.
Verblasste Tinte, Wasserflecken, abgeriebene Notenlinien: Viele historische Handschriften sind mit bloßem Auge kaum noch lesbar. Die multispektrale Bildgebung fotografiert ein Objekt in vielen schmalen Wellenlängenbereichen, vom Ultraviolett bis ins Infrarot, und macht so oft Details sichtbar, die im normalen Foto verborgen bleiben. Um diese Aufnahmen auszuwerten, brauchte man bisher meist eigene Skripte. Die CHARM Toolbox (Cultural Heritage Images Analysis & Recovery) bringt diese Auswertung in eine Desktop-Anwendung, die sich an Bildwissenschaftlerinnen, Restauratoren und Forschende in Museen, Bibliotheken und Archiven richtet.
Entstanden ist sie an der University of Cambridge im Projekt „AI meets cultural heritage“ zur Rekonstruktion beschädigter historischer Notenhandschriften. Das Projekt leitet Dr. Anna Breger von der Cambridge Image Analysis Group. Die Methoden haben Anna Breger und Wallace Peaslee entwickelt, die Benutzeroberfläche Evan Morgan (InScope). Gefördert wurde es vom Cambridge Centre for Data-Driven Discovery und dem Accelerate Programme mit Mitteln von Schmidt Sciences.
In der Toolbox lassen sich Bilder und einzelne Spektralbänder nebeneinander vergleichen, ohne dass die Originaldateien verändert werden. Neben etablierten Verfahren wie der Hauptkomponentenanalyse (PCA) enthält sie Methoden aus der Forschung der Gruppe selbst, etwa räumlich adaptive Analysen und zufällige orthogonale Projektionen (ROP), die Schrift gezielt vom Hintergrund abheben. Mit Masken lassen sich Bereiche wie Tinte oder Pergament markieren und Ergebnisse messbar vergleichen. Wer eigene Ideen umsetzen möchte, kann Python-Skripte direkt in der Toolbox ausführen. Die Software ist frei auf GitHub verfügbar und befindet sich derzeit noch in einer frühen Testphase.
Ergänzt wurde dieser Teil durch einen Einblick in Transkribus, das praktisch den nächsten Schritt in der Bearbeitung der vorher aufbereiteten Dokumente darstellt. Ist eine Handschrift erst einmal wieder lesbar gemacht, geht es darum, ihren Inhalt zu erfassen. Transkribus ist eine Plattform zur automatischen Texterkennung für historische Dokumente, sowohl für Druck als auch für Handschrift. Entwickelt und betrieben wird sie von READ-COOP, einer europäischen Genossenschaft, die den Institutionen und Einzelpersonen gehört, die sie nutzen. Mit inzwischen über 500.000 Nutzerinnen und Nutzern ist Transkribus in Archiven, Bibliotheken und der Forschung weit verbreitet.
Die Plattform erkennt zunächst den Aufbau einer Seite, also Textblöcke, Zeilen und Tabellen, und transkribiert anschließend Zeile für Zeile. Dafür stehen allgemeine Modelle wie der aktuelle „Text Titan II“ zur Verfügung, der auf über 250 Millionen Wörtern trainiert wurde. Hinzu kommt eine große Sammlung öffentlicher Modelle, die Nutzerinnen und Nutzer für bestimmte Jahrhunderte, Sprachen und Schriften trainiert und mit der Community geteilt haben. Reicht das nicht aus, lässt sich mit bereits 25 bis 50 selbst transkribierten Seiten ein eigenes Modell trainieren, das genau auf eine bestimmte Hand oder einen Bestand zugeschnitten ist.
Gerade darin liegt der entscheidende Unterschied zu generischen KI-Sprachmodellen wie ChatGPT. Solche Modelle können zwar auch Bilder von Handschriften lesen, erzeugen aber Text, der vor allem plausibel klingen soll. Unleserliche Stellen werden dabei oft stillschweigend ergänzt, historische Schreibweisen modernisiert oder ganze Passagen erfunden, ohne dass dies erkennbar wäre. Transkribus dagegen verknüpft jede erkannte Zeile mit ihrer genauen Position im Bild, sodass sich jedes Wort direkt am Original überprüfen und korrigieren lässt. Die Ergebnisse sind reproduzierbar, ihre Fehlerquote ist messbar, und durch eigenes Training werden sie mit jeder korrigierten Seite besser. Hinzu kommen die Verarbeitung großer Bestände mit Tausenden Seiten, strukturierte Exportformate für die wissenschaftliche Weiterarbeit und die Datenverarbeitung nach europäischem Datenschutzrecht. Gerade auch im Bezug auf die aktuelle Diskussion um die Lösung des Navier-Stokes-Problems zeigt sich neben der Verwendung von datenschutzrechtlich relevanten Daten für Wissenschaftler aber auch ein neues Problem: Wenn sie Modelle wie ChatGPT nutzen, laufen sie scheinbar Gefahr, dass LLM-Anbieter ihre Arbeit vor Veröffentlichung zum Training eigener Modelle nutzen und Paper veröffentlichen, die auf einmal die eigene Forschung abdecken.
Der Einstieg in die Konferenz war anspruchsvoll aber auch sehr interessant und hat mir jede Menge neue Denkanstöße und Handwerkszeug für aktuelle und künftige Projekte mitgegeben. Gleichzeitig habe ich jetzt erst mal einen Berg Arbeit um diese Sachen alle so abzulegen, dass ich sie in Zukunft auch bei Bedarf wiederfinde.
